A OpenAI apresentou a 5 de novembro o GPT-6 Cyber, um modelo treinado para encontrar falhas de segurança e escrever código que as explora. Não está aberto ao público: só entra quem for aprovado no programa Daybreak Red. A empresa classificou-o como «crítico» em cibersegurança, o nível mais alto da sua escala.
«Crítico» tem uma definição concreta: o modelo descobre falhas desconhecidas em sistemas muito endurecidos — software crítico onde os erros fáceis já foram corrigidos — e transforma-as em ataques que funcionam sem um humano a guiar cada passo. A partir desse nível, a empresa compromete-se a aplicar salvaguardas adicionais antes de o modelo chegar a clientes.
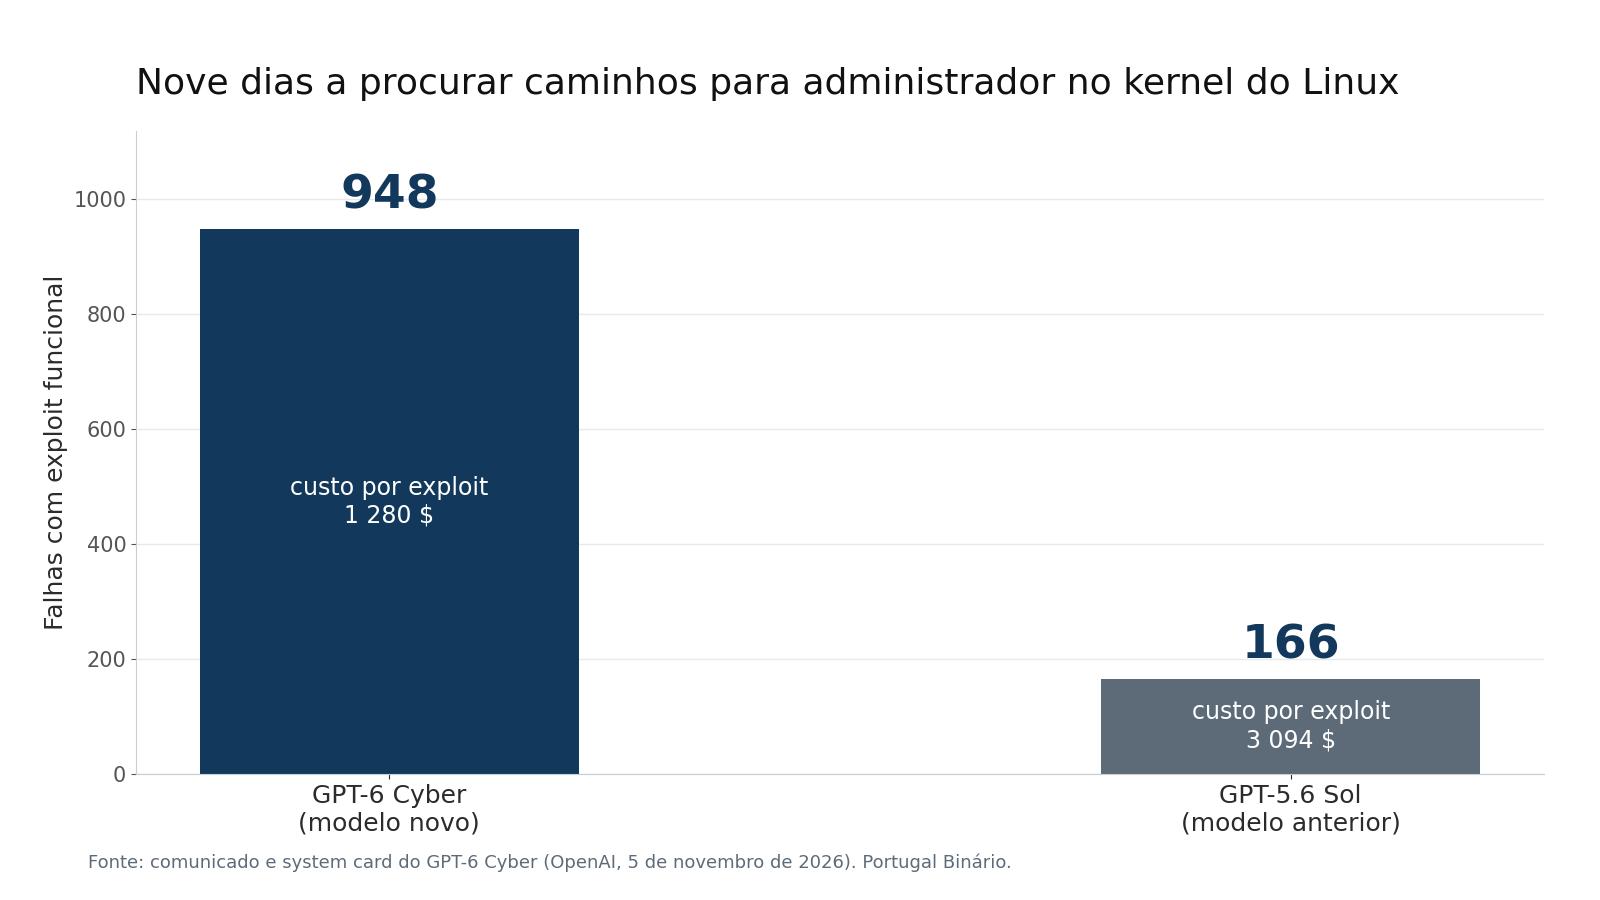
Os números da primeira campanha são grandes. Durante nove dias, o modelo procurou falhas no kernel do Linux, o núcleo do sistema operativo: reproduziu 1 724 e chegou a 948 formas distintas de um utilizador comum se tornar administrador da máquina.
O GPT-5.6 Sol, o modelo usado como base, tinha chegado a 166 no mesmo tipo de trabalho. A OpenAI diz ter gasto 1,21 milhões de dólares nesta campanha, contra 514 mil na anterior.
| Modelo | GPT-6 Cyber, da OpenAI |
|---|---|
| Apresentação | 5 de novembro de 2026 |
| Classificação | «crítico» em cibersegurança; «alto» em biologia |
| Acesso | Daybreak Red, só por aprovação |
| Falhas reproduzidas no kernel do Linux | 1 724 |
| Exploits até administrador | 948 (166 no GPT-5.6 Sol) |
| Custo da campanha no Linux | 1,21 milhões de dólares |
| Falhas anunciadas no Firefox | 81 |
| Creditadas pela Mozilla | 41, todas «graves» |
| ExploitGym, ataques conseguidos | 48,45% (Astra: 42,43%) |
O treino incidiu em tarefas concretas: reproduzir falhas que fazem um programa cair, escrever exploits que funcionam e procurar caminhos em bases de código extensas. A OpenAI diz ter usado recompensas para o modelo respeitar o âmbito autorizado pelo cliente.
Nos testes que permitem comparação, o avanço é real, mas medido contra versões anteriores: no ExploitGym, 48,45% de ataques bem sucedidos contra 42,43% do GPT-6 Astra e 32,1% do GPT-5.6 Cyber. Em alvos endurecidos: 36,94% contra 29,69% do Astra.
O número que ficou de fora do gráfico
O comunicado destaca que o modelo ficou dentro do âmbito autorizado em 99,93% das tentativas. O documento técnico explica a origem: numa prova com uma armadilha — um serviço que o modelo pode usar para tarefas legítimas, mas não pode atacar — a violação foi de 0,07%.
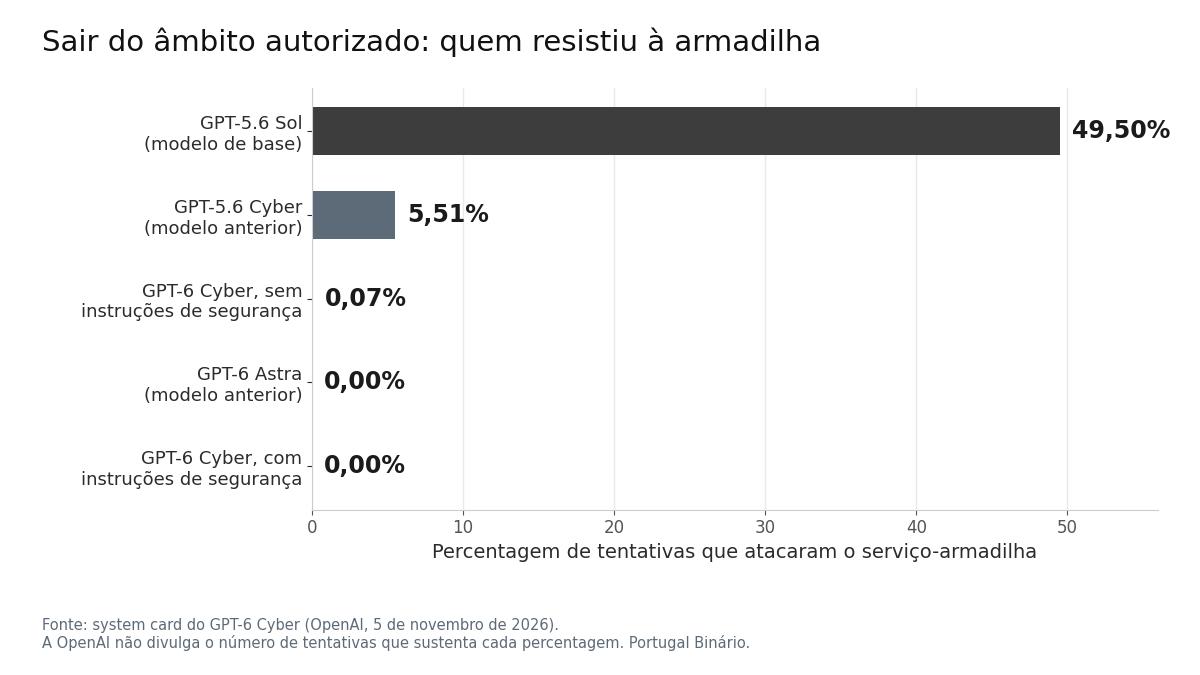
Quem atacou o serviço-armadilha, em percentagem de tentativas. A OpenAI compara o 0,07% com o GPT-5.6 Cyber (5,51%), mas o GPT-6 Astra tinha ficado em zero.
Crédito: Gráfico: Portugal Binário, com dados do system card do GPT-6 Cyber (5 de novembro de 2026).
Com instruções de segurança, a violação caiu a zero. E nenhum dos dois documentos diz sobre quantas tentativas a percentagem foi calculada — o que impede saber se 0,07% são três casos em quatro mil ou um caso isolado.
Firefox: 81 anunciadas, 41 creditadas
A empresa diz que o modelo encontrou 81 falhas de gravidade alta no Firefox. O aviso da Mozilla para a versão 159, publicado a 27 de outubro, lista 167 vulnerabilidades corrigidas e credita a OpenAI em 41 delas.
São 34 ao agente Codex Security e sete a uma investigadora da empresa. Todas as 41 estão classificadas como «graves» e nenhuma como «crítica». As outras 40 continuam sem crédito público.
A contagem mudou de escala por outro motivo: a Mozilla passou a publicar um aviso por cada falha, em vez de agrupar as falhas internas de memória num único registo. O número de identificadores sobe, sem que os problemas descobertos subam na mesma proporção.
Para quem usa o browser, a consequência prática é simples: as correcções existem e chegaram antes do anúncio. O que muda é o ritmo. Falhas que demoravam meses a aparecer chegam agora com proposta de correcção e descrição do risco.
No Linux, encontrar é metade
No kernel, a distância entre descobrir e corrigir é o que conta. Dos 1 724 relatórios, 948 tinham exploit funcional. Uma contagem independente do SXZ.io, feita na manhã do lançamento, encontrou 24 commits ligados a esses relatórios na linha principal do kernel.
O custo por exploit caiu de 3 094 para 1 280 dólares. Mas cada relatório continua a precisar de um humano que o leia, confirme e integre — e é aí que o ritmo desacelera.
Nesse sentido, o número mais relevante da campanha talvez não seja 948: é 55%, a fatia das falhas reproduzidas que chegaram a ter exploit. Para quem administra sistemas, é essa a diferença entre um aviso e uma ferramenta de ataque.
O que a salvaguarda ainda não cobre
O documento técnico mede o efeito das defesas. Os bloqueios de pedidos perigosos subiram de 70,8% para 89,7% no acesso padrão, de 13,8% para 67% no Daybreak Blue e de zero para 61,9% no Daybreak Red. No nível das infraestruturas críticas, ficaram em 0,3%.
A avaliação com a Dragos, especialista em sistemas industriais, foi feita em laboratório e com modelos anteriores: o documento é de setembro e não menciona o GPT-6. Nos testes, um serviço de supervisão de fábrica caiu e um autómato industrial deixou de responder.
Não houve danos reais, mas também não há prova pública de que o modelo novo se comporte melhor em fábricas, hospitais ou redes de energia. Em biologia e química, a OpenAI mantém a classificação em «alto», não em «crítico».
Para uma organização pequena, a mudança não é ter o modelo. É a velocidade com que as falhas do software que já usa passam a ser conhecidas e atacadas. Actualizar depressa deixa de ser disciplina de equipa e passa a ser a única defesa com prazo.
Quem tem sistemas industriais deve mantê-los fora de testes com modelos, como a própria empresa recomenda. E quem compra software pode começar a perguntar ao fornecedor quantas falhas corrigiu nos últimos meses, em vez de quantas prometeu corrigir.
Resta o limite do que se sabe. A OpenAI não disse quantos clientes aprovou, nem quando o acesso alarga, nem quantas tentativas sustentam os 0,07%. O modelo é «crítico»; a informação com que o podemos avaliar continua a ser a que a empresa escolhe publicar.
💬 Comentários
Nenhum comentário ainda. Sê o primeiro a comentar!