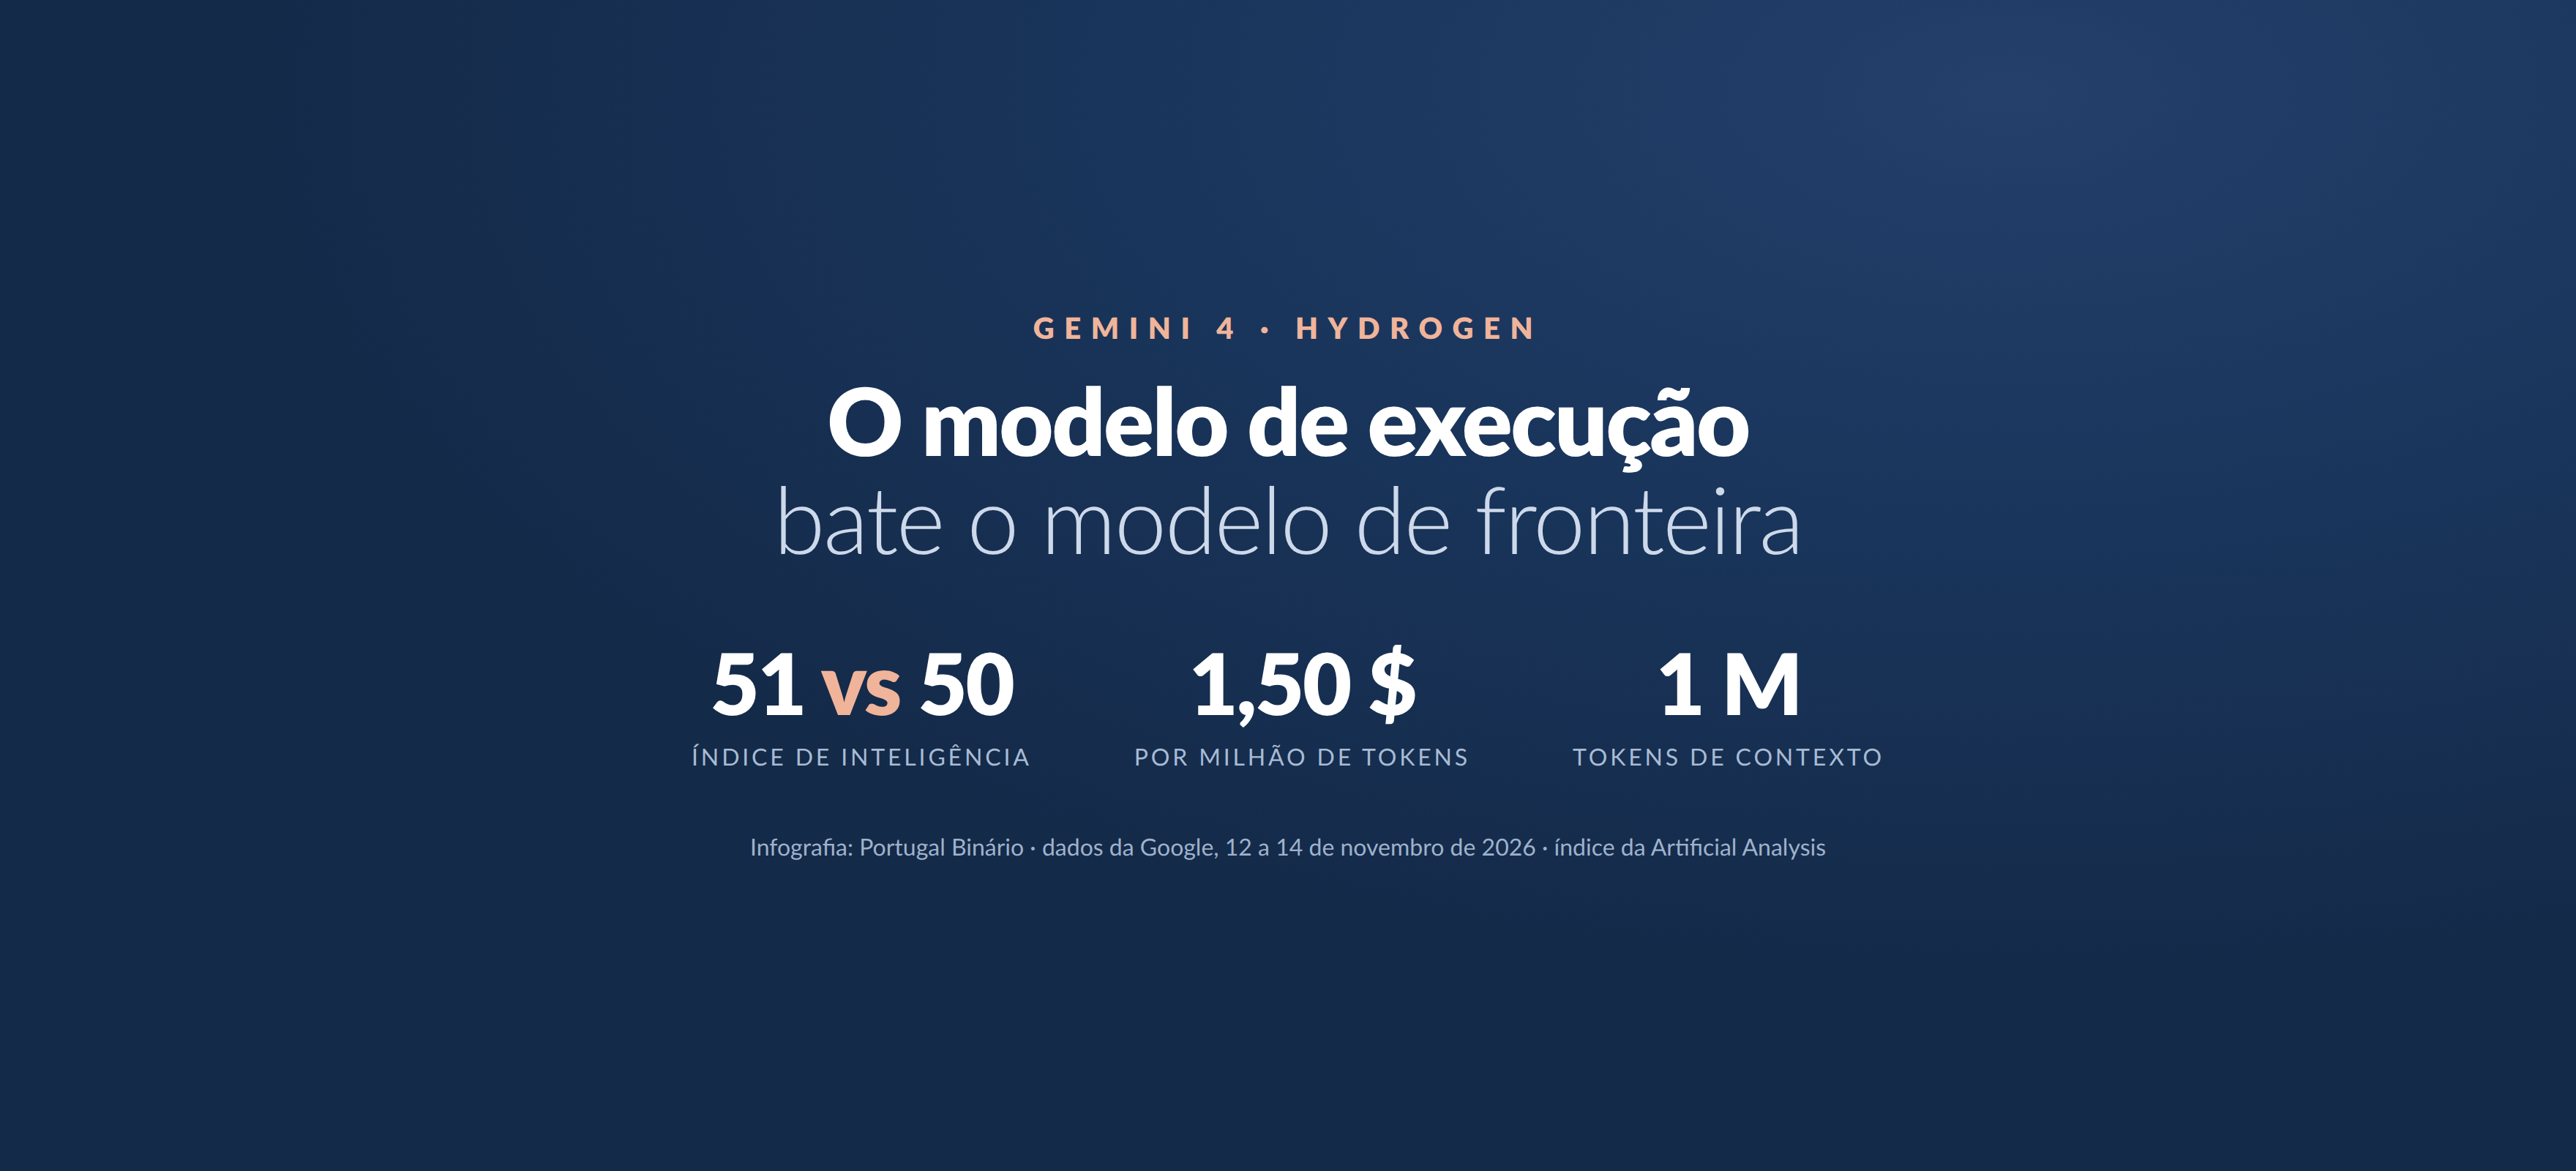
A Google apresentou na quinta-feira o Gemini 4 Hydrogen, o terceiro modelo da família Gemini 4 depois do Carbon e do Argon, e colocou-o a responder na Pesquisa Google para todos os utilizadores. É, segundo a empresa, a maior atualização de modelo de sempre no motor de busca, e chega ao mesmo tempo à API, ao AI Studio, ao Gemini for business, à aplicação Gemini e ao Google Antigravity.
A surpresa está na hierarquia. O Hydrogen não é o modelo mais capaz da casa — é o mais rápido e o mais barato da família —, mas, no nível de raciocínio predefinido, supera o Argon no índice da Artificial Analysis, uma tabela independente que a Google cita: 51 pontos contra 50. No nível máximo de raciocínio, chega aos 54.
O que mudou no preço
O Hydrogen custa 1,50 dólares por milhão de tokens de entrada e 7,50 por milhão de tokens de saída, com preço fixo ao longo de todo o milhão de tokens de contexto. É o dobro do Gemini 3.8 Flash, que cobra 0,75 e 3,75 até 31 de dezembro — e que sobe precisamente para 1,50 e 7,50 a 1 de janeiro de 2027. Ou seja: o Hydrogen já custa hoje aquilo que o Flash passará a custar dentro de semanas.
Frente aos modelos de fronteira, a diferença é outra. O Argon e o Carbon custam 2 e 10 dólares até 30 de novembro e passam a 4 e 20 dólares a 1 de dezembro. Nessa data, o Hydrogen fica a menos de metade do preço dos dois. A Google conta todos os tokens processados, incluindo os de raciocínio e as instruções internas de ferramentas, pelo que o custo real de uma tarefa depende de quanto o modelo «pensa» antes de responder.
| Gemini 4 Hydrogen | 1,50 $ entrada / 7,50 $ saída por milhão de tokens |
|---|---|
| Gemini 3.8 Flash | 0,75 $ / 3,75 $ até 31/12/2026; 1,50 $ / 7,50 $ a partir de 01/01/2027 |
| Gemini 4 Argon | 2 $ / 10 $ até 30/11/2026; 4 $ / 20 $ a partir de 01/12/2026 |
| Gemini 4 Carbon | 2 $ / 10 $ até 30/11/2026; 4 $ / 20 $ a partir de 01/12/2026 |
| Contexto do Hydrogen | 1 milhão de tokens de entrada e de saída |
| Cache de contexto | 0,075 $ por milhão (apenas implícito) |
Porque é que a Google lhe chama modelo de execução
A empresa divide agora o trabalho em duas fases. Para arquitetura de sistemas, problemas difíceis e raciocínios longos, aponta o Carbon e o Argon. Para escrever código, correr testes, verificar alterações e executar tarefas em vários passos, diz que o Hydrogen é suficiente — e mais barato. No Antigravity, o ambiente de programação da Google, um «orquestrador» passa a alternar entre modelos dentro da mesma sessão: segundo a empresa, alcança resultados próximos do Carbon no Terminal-Bench 4.0 gastando, em média, 24% menos quota e terminando 19% mais depressa.
Face ao Flash que substitui, a Google promete tarefas concluídas 2,5 vezes mais depressa no nível predefinido, uma subida de 18,2% para 57% no Terminal-Bench 4.1 e cinco vezes menos afirmações inventadas. Parceiros que testaram o modelo em fluxos com bases de dados e SQL relatam execuções 2 a 2,8 vezes mais rápidas, com 12% a 23% menos tokens.
O que muda para quem pesquisa
Na Pesquisa, o Hydrogen passa a interpretar perguntas com várias partes, a lançar pesquisas paralelas sobre os subtemas e a devolver respostas com imagens, tabelas comparativas e ligações — em todas as línguas que o modo de IA da Google já suporta. A empresa garante que está disponível «globalmente», sem detalhar exceções por país ou idioma.
O que os números ainda não provam
Todos os valores de desempenho são da Google, medidos nos seus próprios testes ou citados de um índice que ela escolheu destacar. Até ao fecho desta notícia não foi localizada uma replicação independente do Terminal-Bench nem uma avaliação pública da qualidade do modelo com um milhão de tokens de contexto — o número que a empresa usa como argumento comercial. Também não é público quanto do ganho de velocidade se mantém em português ou em documentos longos fora do inglês.
Para quem paga, a conta é simples de fazer e convém fazer antes de migrar. Um relatório de 100 mil tokens de entrada com uma resposta de 2 mil tokens custa cerca de 0,165 dólares no Hydrogen: 15 cêntimos pela leitura, 1,5 cêntimos pela resposta. O mesmo trabalho no Argon, a partir de dezembro, custa 0,44 dólares. A diferença só compensa se a qualidade da execução se mantiver — e é isso que os próximos meses de uso real vão dizer.
Fica uma pergunta de mercado. Ao subir o preço do Flash para o nível do Hydrogen e ao duplicar o preço do Argon em dezembro, a Google afasta os modelos de fronteira de quem tem contas pequenas e empurra todo o trabalho diário para um modelo que, nos seus próprios números, já bate o Argon no índice de inteligência. Se a promessa se confirmar fora dos testes da empresa, o modelo mais barato deixa de ser o modelo de segunda escolha.
💬 Comentários
Nenhum comentário ainda. Sê o primeiro a comentar!