A NVIDIA abriu a 15 de outubro a família Nemotron 3.5, com um modelo que muda a conta do que cabe num computador de secretária: o Bolt 74B-A9B guarda 74 mil milhões de parâmetros em cerca de 24 GB.
É o mesmo espaço que ocuparia um modelo de 30 mil milhões em precisão normal. Os pesos estão no Hugging Face sob a licença OpenMDW-1.1 e entram no llama.cpp, no Ollama e no LM Studio.
O Bolt não é um transformador clássico. É um híbrido de Mamba-2 com transformador, activa cerca de 9 mil milhões de parâmetros por passo e aceita texto, imagem e vídeo através de um codificador de visão.
Porque é que 74 mil milhões cabem em 24 GB
A compressão usa o formato IQ2_XXS, com 2,0625 bits por elemento em todos os especialistas, e não foi feita depois do treino: a NVIDIA treinou o modelo a recuperar precisão dentro do formato final. As camadas Mamba ficam em NVFP4 e as entradas e saídas em Q8_0, o que explica o total de cerca de 24 GB.
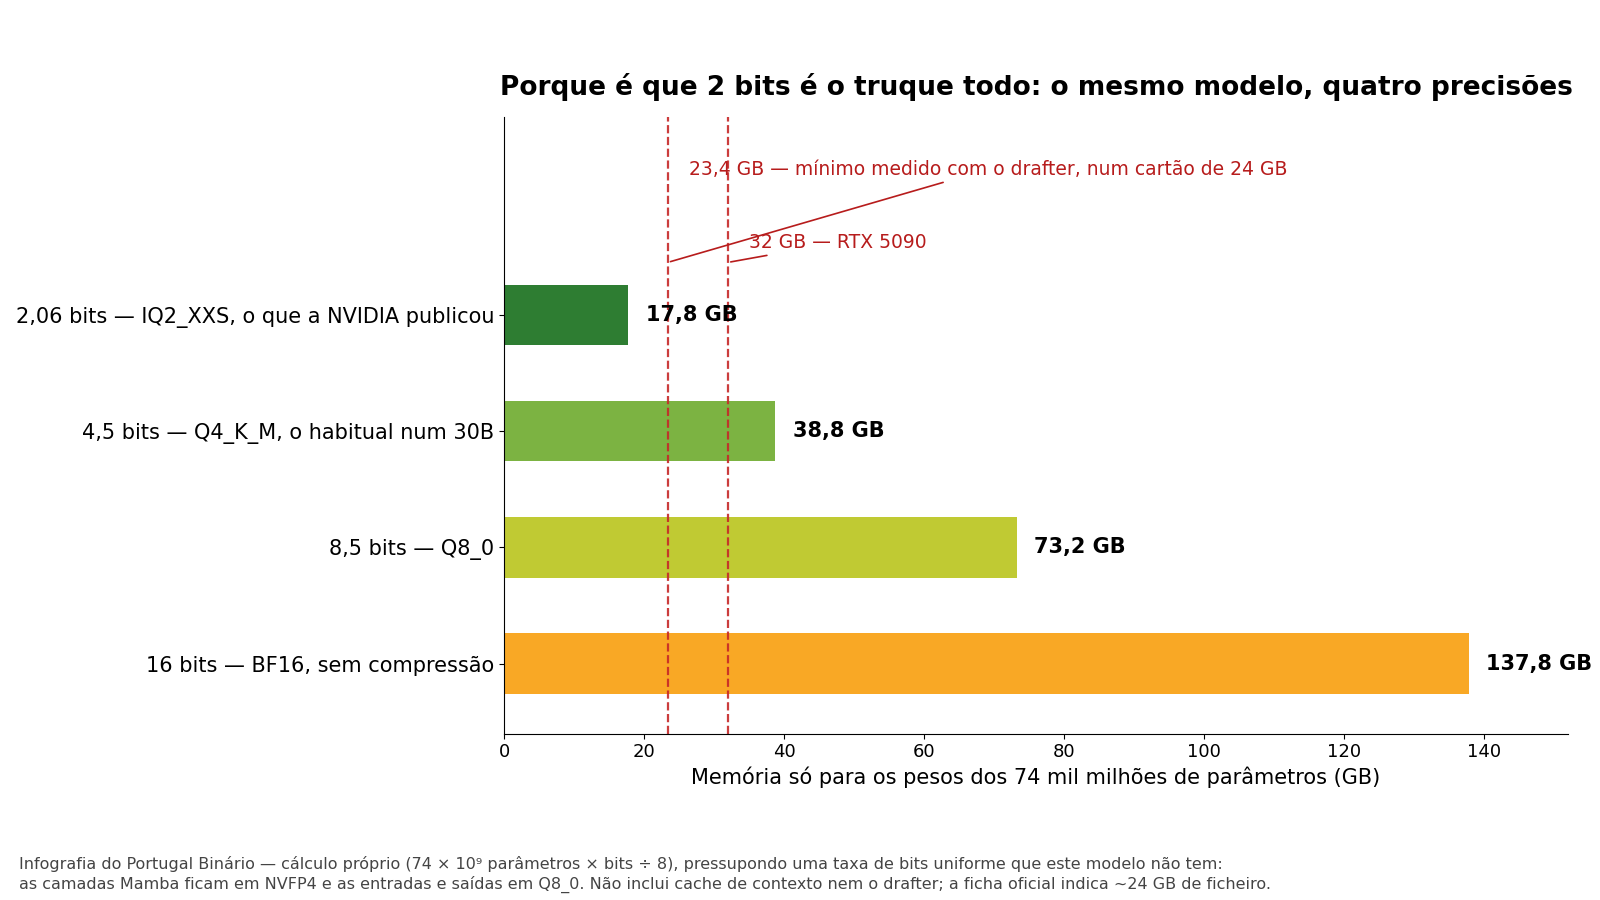
O mesmo número de parâmetros em quatro precisões. A 2,06 bits os pesos dos 74 mil milhões ocupam 17,8 GB; a 16 bits, 137,8 GB. O cálculo é do Portugal Binário e pressupõe uma taxa de bits uniforme que este modelo não tem.
Crédito: Infografia do Portugal Binário — cálculo próprio a partir da contagem de parâmetros da NVIDIA
A NVIDIA escreve na ficha do modelo que há «pouca ou nenhuma degradação na precisão do texto». É uma afirmação da empresa, não um resultado independente: falta uma avaliação pública que confirme a taxa de erro em tarefas longas de agentes, o uso anunciado.
Duas receitas, duas máquinas
As configurações publicadas pela própria NVIDIA dividem os utilizadores em dois grupos. Com 128 GB de memória unificada, ou uma placa de 48 GB ou mais, o modelo corre com 262 144 tokens de contexto e até sete tokens de rascunho por passo.
Com 64 GB unificados, ou uma placa de 32 GB ou mais, o contexto desce para 65 536 tokens e o rascunho para seis.
| Parâmetros | 74 mil milhões, com 9 mil milhões activos por passo |
|---|---|
| Contexto máximo anunciado | 256 000 tokens |
| Formato dos pesos | IQ2_XXS, 2,0625 bits por elemento |
| Camadas Mamba | NVFP4 |
| Entradas e saídas | Q8_0 |
| Acelerador especulativo | drafter LiLiCorr, até 7 tokens por passo |
| Licença | OpenMDW-1.1 |
| Pesos publicados | 15 de outubro de 2026 |
| No Ollama | desde 14 de outubro, versão 0.40.5 |
| Versão pequena | Bolt E4B, 4 GB, a 23 de outubro |
Onde corre, e onde o truque encrava
Os pesos em GGUF estão no Hugging Face e o modelo entra nas bibliotecas de sempre: llama.cpp, Ollama, LM Studio, Unsloth e vLLM. A NVIDIA testou-o em H100, H200, GB200, RTX 5090, DGX Spark e nos portáteis RTX Spark, que chegaram a 16 de outubro.
Medido durante a integração no llama.cpp, o reverso da promoção: com o acelerador especulativo ligado o mínimo observado é de 23,4 GB, o que não cabe num cartão de 24 GB — nesse caso o rascunho fica desligado. A partir de 32 GB volta a ligar-se, com 26,4 GiB de pico e uma taxa de aceitação de 0,917.
Nos Mac o caminho é mais estreito. O formato NVFP4 que a NVIDIA usa não tem equivalente no Metal, e a alternativa é uma reconversão Q8_0 da comunidade, que corre a 12-24 tokens por segundo num M5 Pro de 64 GB. Um M4 Pro de 24 GB não chega.
O que isto muda
A ficha do modelo declara-o pronto para uso comercial e não comercial e remete para o texto da licença OpenMDW-1.1, sem limiares de facturação nem condições sobre a apresentação da marca. É a mesma licença da geração anterior da família e a diferença mais concreta em relação a outras «aberturas» recentes, que mantêm portas de marca.
O resto da família merece nota. O Super VL 120B-A12B, com 12 mil milhões de activos, foi treinado em cerca de 26 biliões de tokens e destina-se a servidores e estações de trabalho.
O Bolt E4B, de 4 GB, chega a 23 de outubro para portáteis e placas pequenas. Os números de desempenho divulgados — primeiro modelo aberto da sua classe no PinchBench, segundo no BrowseComp — são medições da própria NVIDIA.
Fica a pergunta prática: 2 bits treinados de origem aguentam o que a comunidade lhes faz a seguir — afinação, quantizações adicionais, uso em ferramentas que não sejam o llama.cpp? É aí que se verá se a compressão foi uma decisão de arquitectura ou apenas um número de catálogo.
💬 Comentários
Nenhum comentário ainda. Sê o primeiro a comentar!