Linus Torvalds publicou um ramo com oito patches que remove a referência que cada leitura de ficheiro tomava à cache de páginas do Linux. A mensagem da série atribui o código, os testes, a revisão e o primeiro esboço do texto a um assistente Claude Code, sob a sua direção.
As medições são dele, num só portátil: 9,9 a 10,4 milhões de leituras de 16 bytes por segundo com oito threads antes da série, 30 a 33 milhões depois. O ramo assenta em 7.3-rc6 mais correções e não entrou em nenhum kernel publicado.
O contador que oito núcleos disputam
Uma leitura pequena de um ficheiro em cache copia os bytes para o processo e larga a referência que tomou à página. Com oito threads no mesmo ficheiro, esse contador é disputado e cada leitura escreve duas vezes a mesma linha de memória — no portátil do autor, 99,92% dos conflitos de cache medidos.
O caso não é novo: Matthew Wilcox levantou-o em 2024, a partir da carga de um cliente. Durante dois anos, as tentativas copiavam sem referência para um buffer intermédio e validavam no fim; paravam nos casos em que validar não chega — páginas migradas ou reaproveitadas no mesmo índice.
A solução que ficou é mais radical: a página deixa de voltar ao alocador assim que sai da cache e espera um período de graça do RCU. Quem a encontra dentro da secção RCU sabe que os bytes não são reaproveitados enquanto lá estiver, e copia-os diretamente para o processo.
O que ele mediu
Nas medições do próprio autor, as leituras por segundo com oito threads passam de 9,9–10,4 para 30–33 milhões, o custo por leitura cai de 2 937–2 975 para 725–726 ciclos de kernel, e os conflitos entre caches caem de 30 538 para 101.
| Leituras de 16 bytes, 1 thread | 7,9–8,1 milhões/s antes · 8,8–8,9 milhões/s depois |
|---|---|
| Leituras de 16 bytes, 8 threads | 9,9–10,4 milhões/s antes · 30–33 milhões/s depois |
| Ciclos de kernel por leitura, 1 thread | 452–454 antes · 408–409 depois |
| Ciclos de kernel por leitura, 8 threads | 2 937–2 975 antes · 725–726 depois |
| Conflitos entre caches (load HITM, 8 threads) | 30 538 antes · 101 depois |
| Base da série | 7.3-rc6 mais correções (0c2669a9f4a1) |
| Estado do ramo | noref-filemap-read-with-llm, não integrado a 12 de outubro |
| Máquina medida | portátil Core i7-8565U, 4 núcleos e 8 threads, ext4, mitigações desligadas |
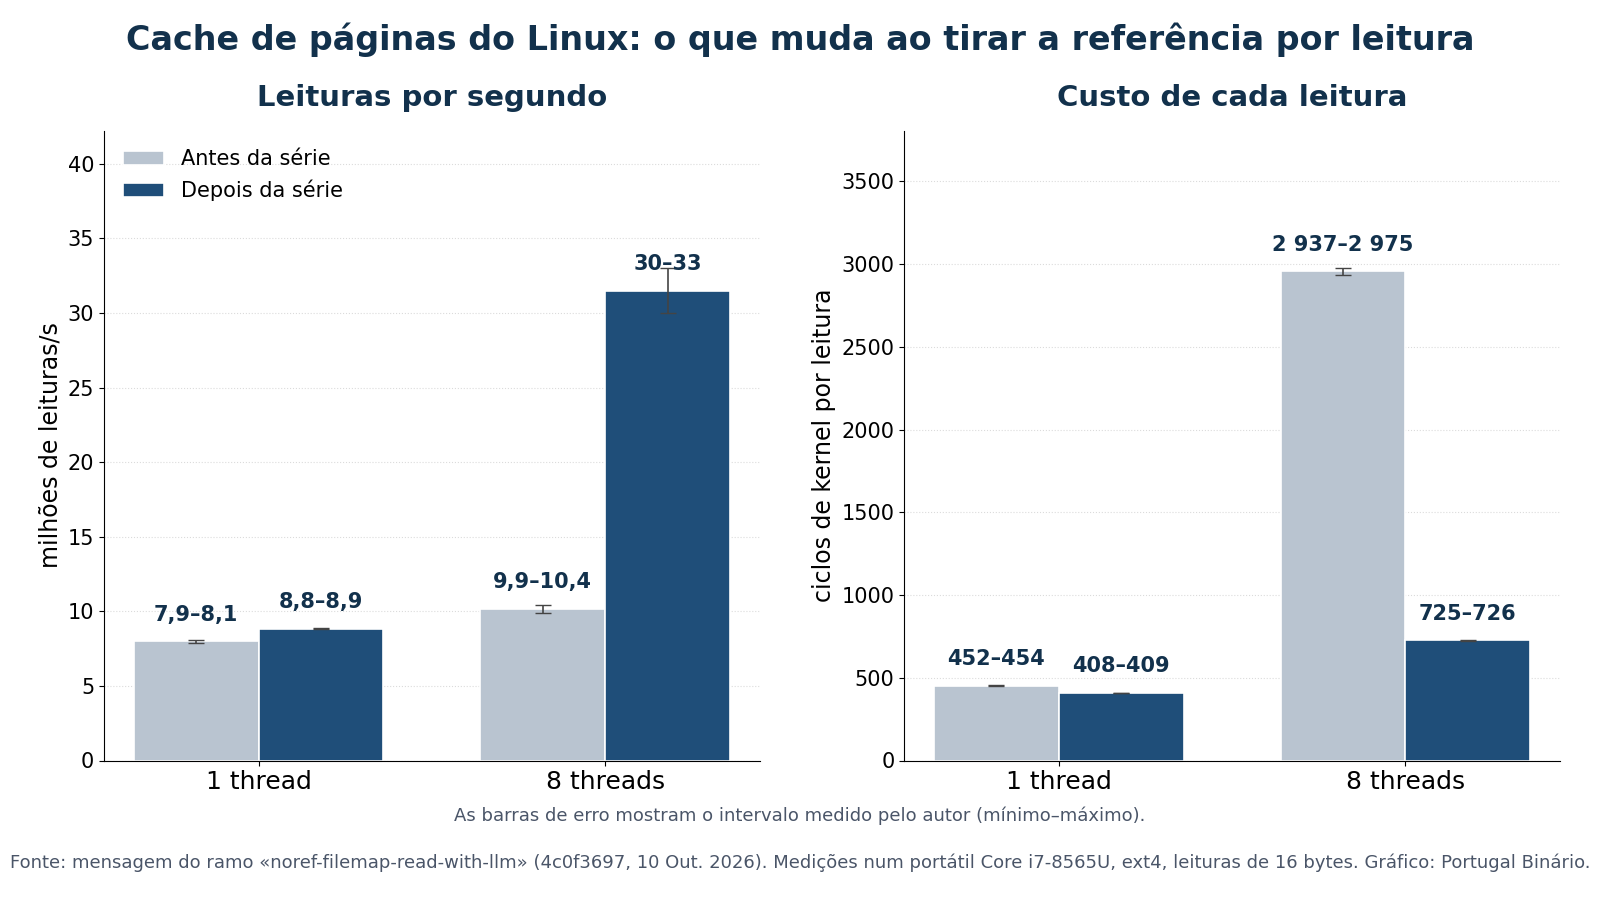
Leituras de 16 bytes a um ficheiro em cache, antes e depois da série que tira a referência por leitura. As medições são de Linus Torvalds, num portátil Core i7-8565U; as barras de erro dão o intervalo publicado. Gráfico do Portugal Binário.
Crédito: Gráfico: Portugal Binário, a partir dos valores da mensagem do ramo (10 de outubro de 2026)
O autor desfaz o entusiasmo. É um portátil, um só die, ext4, mitigações desligadas; a máquina aquece e baixa de frequência, e por isso pede que se compare o custo por leitura, não as leituras por segundo. Diz que uma máquina maior deve ganhar mais — e que não mediu nenhuma.
Há também um custo novo, medido: ler para uma página do processo que ainda não está presente paga uma exceção falhada a mais por leitura — de 4 117–4 188 para 6 543–6 593 ciclos, no caso de 16 bytes com uma thread. As leituras grandes mantêm-se no caminho rápido.
A parte que continua sem resposta
O problema que fica é o que o próprio autor chama o menos resolvido. As páginas à espera do período de graça são invisíveis ao alocador: têm contagem de referências zero, não são páginas livres, não estão em lista nenhuma e não aparecem em contador nenhum.
Nas primeiras seis partes da série, um reprodutor de Kiryl Shutsemau matava por falta de memória dentro de uma máquina virtual de 2 GiB. Com as duas partes seguintes, que encurtam as listas, o mesmo teste corre até ao fim — mas o alocador continua a não ver o que lá está.
As médias de memória à espera caem de 148, 565, 503 e 540 MiB (com 1, 4, 8 e 16 processos) para 6,6, 15, 70 e 177 MiB. Os picos chegam a 870 MiB e a função que expede cada lote, synchronize_rcu_expedited(), corre 4 600 vezes por segundo — a sua documentação diz para não a usar em ciclo.
Há ainda uma regressão declarada: alloc_contig_range() devolve -EBUSY à espera destas páginas, e a memória contígua que a CMA reserva passa ao bloco seguinte. Torvalds escreve que a correção exige um cookie por lote e uma libertação dentro de test_pages_isolated(), e que não a escreveu.
Nos testes que existem, quatro leitores verificam cada byte enquanto outro expulsa o ficheiro da cache: zero leituras erradas em corridas de cerca de 10^8. Com um patch de depuração que liberta imediatamente, o mesmo teste apanha 12 e 138 leituras erradas. Fora isso, não houve xfstests, lockdep, KASAN, clang, 32 bits nem outra máquina.
No mesmo fim de semana, a outra ponta
No fim de semana em que publicou o ramo da cache, Torvalds etiquetou uma segunda série, sobre a árvore associativa que o kernel usa para chaves e para a gestão de recursos. São doze patches: dois corrigem erros de 2013 e os outros dez não mudam comportamento.
O primeiro exige dezoito inserções e uma remoção para aparecer, e acaba num BUG_ON. O segundo surge quando uma alocação falha a meio da cópia de uma árvore. Ambos vieram de testes em espaço de utilizador: um com inserções e remoções aleatórias, outro a falhar cada alocação à vez.
A etiqueta que os acompanha não é nova. A documentação do kernel sobre assistentes de IA exige «Assisted-by: LLM» e, desde a revisão que entrou na árvore a 20 de agosto, deixou de pedir o nome do modelo. Mantém o essencial: um agente não pode assinar; quem certifica a origem é uma pessoa.
Isto ainda não é um kernel. O ramo espera a janela de fusão, e o que vai decidir o seu destino não é o ganho de três vezes nas leituras pequenas: é a resposta à pergunta que o autor deixou em aberto — como é que o alocador passa a ver a memória à espera.

💬 Comentários
Nenhum comentário ainda. Sê o primeiro a comentar!